
Как ChatGPT выбирает источники и как попасть в ответы
Разбор того, как ChatGPT ищет и цитирует сайты: боты OpenAI, критерии отбора, расхождения в данных исследований и конкретные шаги для сайта.
 Команда LuchanLabsSEO и GEO-стратеги14 мин чтения
Содержание статьи
- Всегда ли ChatGPT берёт ответы из интернета?
- Как ChatGPT выбирает источники, когда ищет в сети?
- Какие боты OpenAI заходят на сайт и чем они отличаются?
- По каким критериям ChatGPT выбирает, какой источник процитировать?
- Достаточно ли топ-10 Google, чтобы попасть в ответы ChatGPT?
- Каким должен быть контент, чтобы его процитировали?
- Какие технические условия нужны, чтобы сайт попал в поиск ChatGPT?
- Помогают ли упоминания бренда на сторонних сайтах?
- Как проверить, цитирует ли ChatGPT ваш сайт?
- Какие ошибки мешают попасть в ответы ChatGPT?
- FAQ
- С чего начать на этой неделе
Как ChatGPT выбирает источники, OpenAI подробно не раскрывает, но картина складывается из официальной документации и независимых исследований. Модель не всегда ходит в интернет, а когда ходит, переписывает вопрос в несколько поисковых запросов и цитирует лишь около половины найденных страниц. Ниже разобрано, что известно достоверно, что показали исследования, что остаётся гипотезой и какие шаги сайт может сделать уже сейчас.
Всегда ли ChatGPT берёт ответы из интернета?
Нет. ChatGPT запускает веб-поиск автоматически, когда считает, что вопрос выиграет от данных из сети, либо когда пользователь включает поиск вручную. Во всех остальных случаях модель отвечает без обращения к сайтам, и источников в ответе не будет. Это первое условие любой видимости: нет поиска, нет цитирования.
Насколько часто поиск запускается, зависит от типа вопросов. В тесте iSonic от 9 сентября 2026 года 432 вопроса для создателей контента отправили через API ChatGPT с включённым веб-поиском. Поиск сработал для 153 вопросов (около 35%), а в среднем на ответ пришлось 0,9 источника.
У этой цифры две оговорки. Тест шёл через API, а не через приложение ChatGPT, и поведение приложения может отличаться. Вопросы были одной тематики, поэтому переносить 35% на любые запросы нельзя. Практический вывод скромнее: для части ваших тем ChatGPT вообще не будет искать в сети, и бороться за цитату там бессмысленно. Начинать стоит с вопросов, где поиск запускается почти наверняка: сравнения, актуальные цены, «что лучше», недавние изменения.
Как ChatGPT выбирает источники, когда ищет в сети?
ChatGPT переписывает вопрос пользователя в один или несколько целевых поисковых запросов и отправляет их в поиск, иногда через партнёрских поисковых провайдеров. Из найденного пула страниц он затем выбирает, что процитировать. Панель Sources показывает цитируемые источники и другие релевантные ссылки, а место в ней не гарантировано.
Справка OpenAI даёт пример такой цепочки. Запрос о препаратах против CCR8 сначала превращается в запрос о разработке иммунотерапии, затем в более узкий запрос о конкретной молекуле и научной конференции. Полный список партнёров OpenAI не раскрывает, поэтому сказать, какие именно индексы стоят за поиском, нельзя.
Для обычного бизнес-вопроса схема выглядит так. Ниже иллюстрация, а не реальный лог ChatGPT: вопрос «Какую CRM выбрать для небольшого интернет-магазина?» может разойтись на подзапросы «CRM для интернет-магазина сравнение», «CRM интеграция с Новой почтой» и «цены на CRM для малого бизнеса». Каждый подзапрос приносит свой набор страниц. Страница, которая отвечает на один узкий подзапрос точно, имеет больше шансов, чем универсальная, которая отвечает на исходный вопрос в общих чертах.
Исследование Ahrefs от 15 апреля 2026 года (1,4 млн промптов) показывает масштаб отбора. ChatGPT в среднем достаёт около 16,57 цитируемых и около 16,58 нецитируемых URL на промпт, то есть цитируется примерно половина найденного. Из цитируемых URL 88% приходят из канала general search. Ahrefs оговаривает, что ChatGPT закрытая модель, а оценки приблизительны. Эту цифру нельзя напрямую сравнивать с 6,88 цитаты на промпт из другого исследования (см. FAQ): выборки, модели и способы подсчёта у них разные.
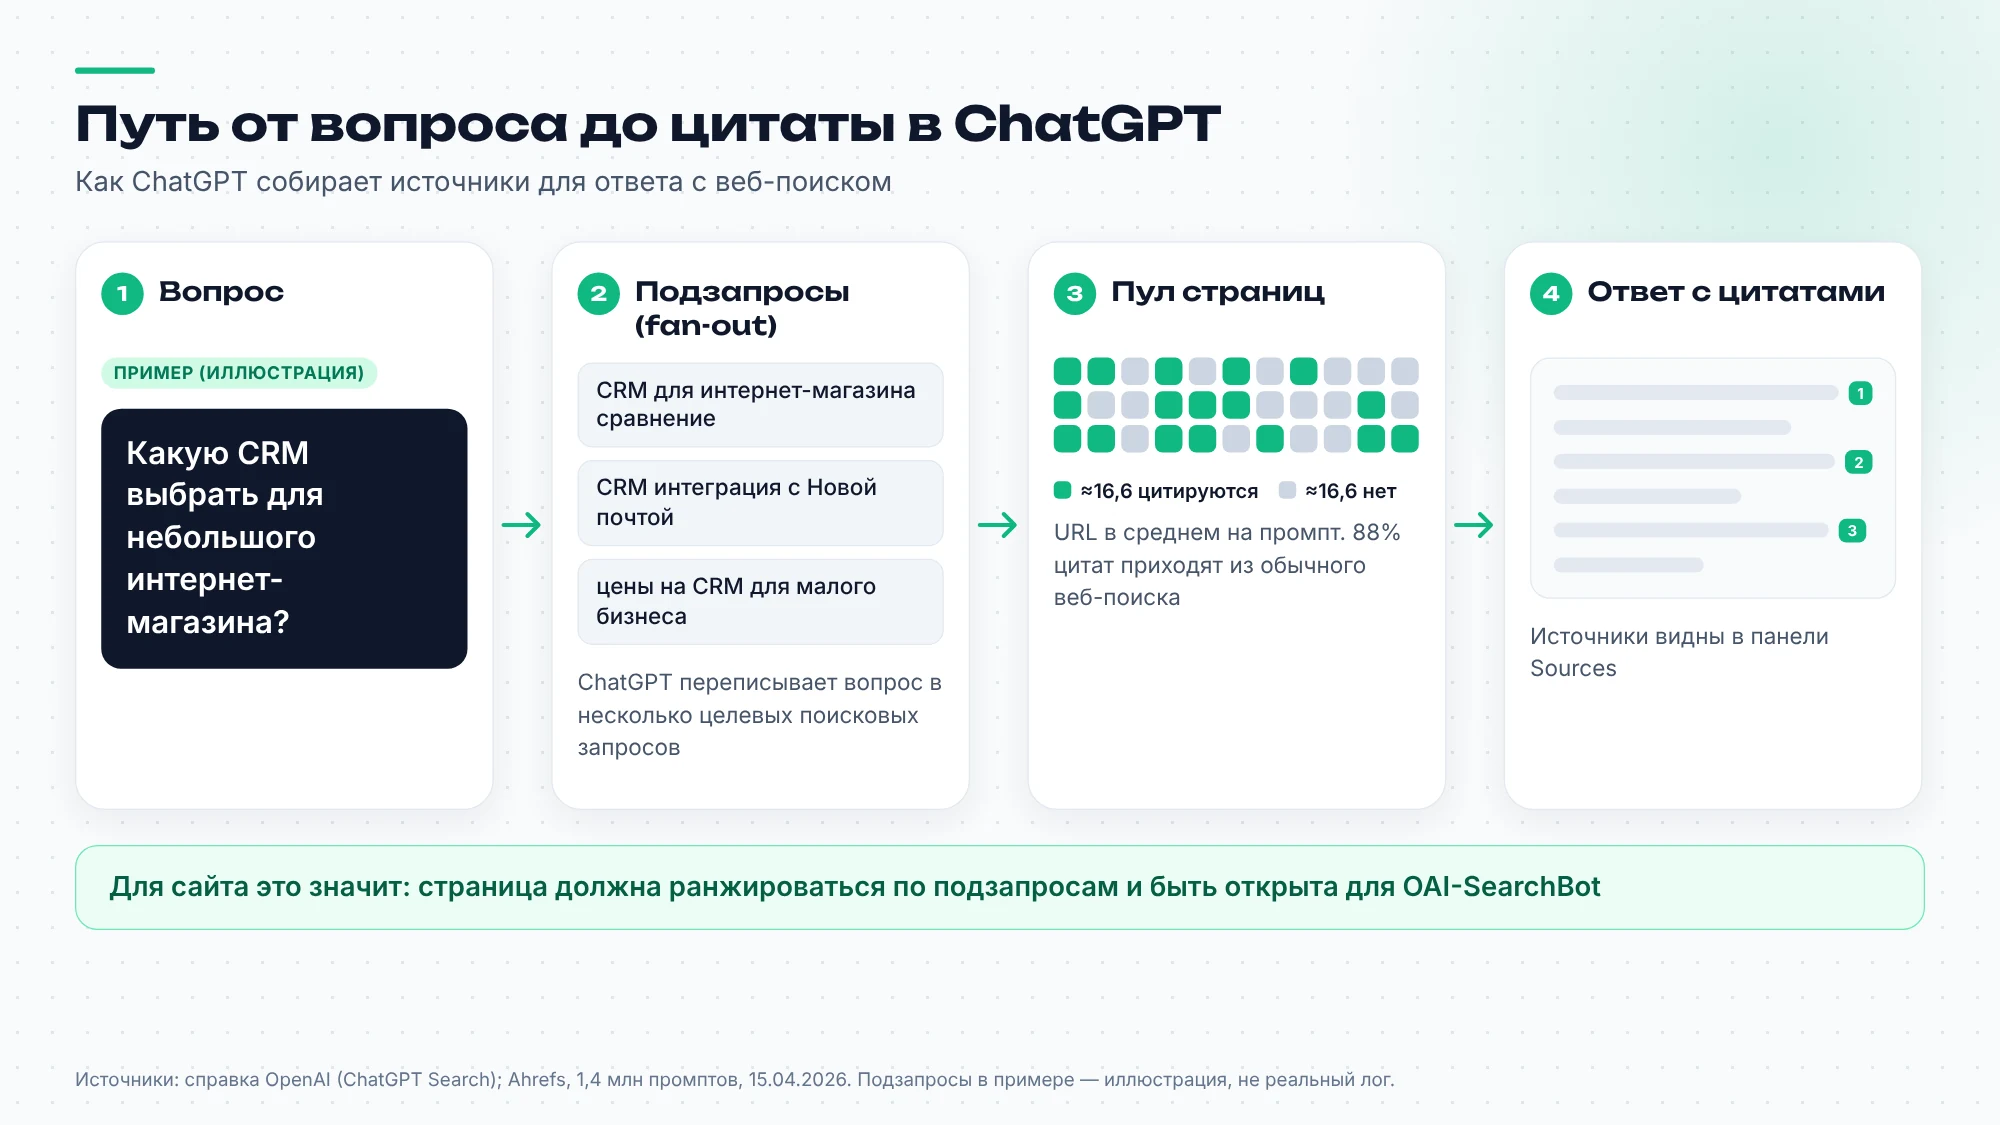
~50% найденных URL ChatGPT цитирует, остальные ~50% остаются в пуле без цитаты. — Ahrefs, 15 апреля 2026, 1,4 млн промптов
Какие боты OpenAI заходят на сайт и чем они отличаются?
У OpenAI три бота с разными задачами: GPTBot собирает данные для обучения моделей, OAI-SearchBot формирует показ сайтов в поиске ChatGPT, ChatGPT-User выполняет действия, запущенные пользователем. Настройки ботов независимы: закрыв один, вы не закрываете остальные, поэтому для видимости в ответах критичен именно OAI-SearchBot.
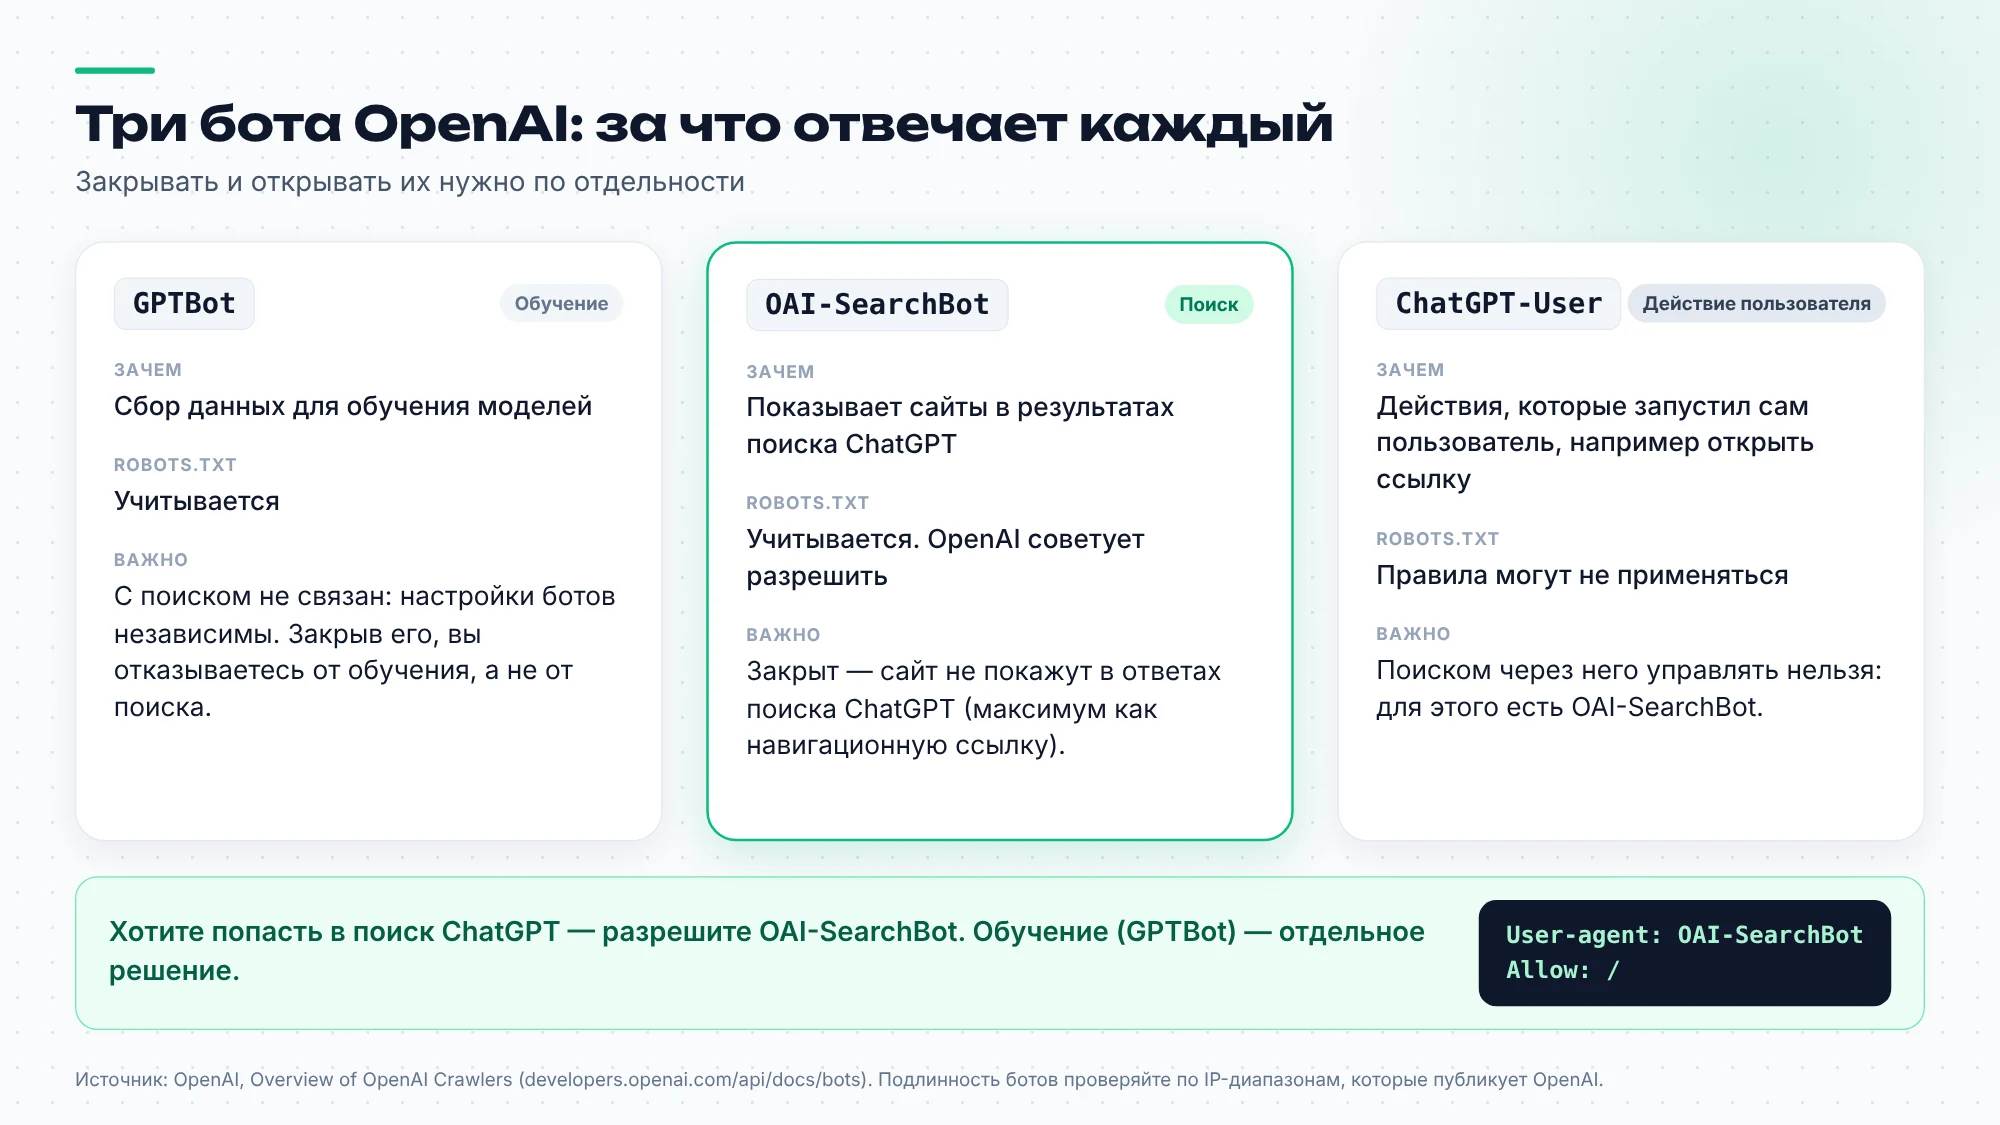
| Бот | Назначение | Учитывает ли robots.txt | Влияет ли на появление в поиске ChatGPT |
|---|---|---|---|
| GPTBot | Обучение моделей | Да | Нет, он отвечает за обучение, а не за поиск |
| OAI-SearchBot | Показ сайтов в поиске ChatGPT | Да; OpenAI рекомендует его разрешить | Да, это бот поискового слоя |
| ChatGPT-User | Действия, запущенные пользователем | Правила robots.txt к нему могут не применяться | В документации описан как инструмент действий пользователя, а не индексации |
Для OpenAI рекомендация однозначна: разрешить OAI-SearchBot в robots.txt и пропустить запросы с опубликованных IP-диапазонов. Диапазоны лежат в JSON-файлах: openai.com/searchbot.json, openai.com/gptbot.json и openai.com/chatgpt-user.json.
Типичный выбор владельца сайта: быть в поиске ChatGPT, но не отдавать контент на обучение. Он реализуется так:
# Разрешаем бот поиска ChatGPT
User-agent: OAI-SearchBot
Allow: /

# Запрещаем сбор данных для обучения моделей (по желанию)
User-agent: GPTBot
Disallow: /

# Действия, запущенные пользователем
# OpenAI предупреждает, что к ChatGPT-User правила robots.txt могут не применяться
User-agent: ChatGPT-User
Allow: /
Блок GPTBot с Disallow: / это решение бизнеса, а не техническое требование. Если вы не против обучения на ваших материалах, его можно не добавлять. Блокировка GPTBot, по документации, на показ в поиске не влияет.
По каким критериям ChatGPT выбирает, какой источник процитировать?
Официально OpenAI говорит лишь, что ранжирование идёт по нескольким факторам и место в ответе не гарантируется. Исследования дают косвенные признаки: цитируемые страницы ближе по смыслу заголовка к запросу и подзапросам, чаще повторяются в выдаче по разным подзапросам и нередко отвечают в начале страницы.
Ahrefs измерил близость заголовка к запросу как косинусную близость эмбеддингов. К исходному промпту она составила 0,602 у цитируемых страниц и 0,484 у нецитируемых. К внутренним подзапросам (fan-out) у цитируемых страниц она равна 0,656. Это самый чёткий сигнал из доступных: заголовок, который совпадает по смыслу с вопросом и его подвопросами, коррелирует с цитированием.
Препринт Национального университета Сингапура «Understanding ChatGPT Citations…» (2026, не рецензирован; 80 запросов на китайском и английском, модели ChatGPT 5.2-5.5) добавляет второй признак. Страницы, которые повторяются в выдаче по разным подзапросам, цитируются чаще. Авторы также отмечают, что выдача шумная: один и тот же вопрос может дать разные пулы страниц.
Третий признак пришёл из вторичного источника. По пересказу анализа 1,2 млн ответов на ziptie.dev, 44% цитат берутся из первой трети страницы. Саму методику мы не проверяли, поэтому относитесь к цифре как к ориентиру.
Ещё одна деталь из Ahrefs: ChatGPT массово достаёт YouTube и arXiv, но цитирует их редко. Reddit даёт 67,8% нецитируемых URL и только 1,93% цитат. Попадание страницы в пул не означает цитату.
Важная оговорка самого Ahrefs: надёжных выводов о роли сниппетов и дат публикации сделать нельзя. Все перечисленные признаки это корреляции, причинность не доказана.
Достаточно ли топ-10 Google, чтобы попасть в ответы ChatGPT?
Нет, и данные исследований расходятся. По Ahrefs, только около 8% цитат ChatGPT приходятся на страницы из топ-10 Google, тогда как по раннему тесту Seer Interactive 87% цитат совпали с топ-10 Bing. Единой цифры нет: у исследований разные метод и период, поэтому усреднять эти значения нельзя.
Вот все данные, которые мы нашли, с методом каждого:
- Ahrefs, около 15 000 промптов, данные июля 2025: 8% цитат ChatGPT в топ-10 Google и около 8,1% в топ-10 Bing.
- Seer Interactive, 500+ цитат, начало 2025: 87% совпали с топ-10 Bing. Выборка маленькая и ранняя, метод известен нам в пересказе.
- GeekyTech, 2026: пересечение доменов 0,104 с Google и 0,035 с Bing. Здесь другая метрика, домены, а не URL.
- Препринт NUS: Google Search и OpenAI Responses API вместе воспроизводят около четверти цитируемых URL, но около половины цитируемых хостов.
Расхождение объясняют четыре фактора. Первый: метрика. Совпадение по точному URL всегда ниже, чем по домену или хосту: ChatGPT может процитировать другую страницу того же сайта, который есть в топе. Второй: время. Данные собирались в разные периоды, а поисковый слой ChatGPT менялся. Третий: версии модели. Препринт NUS тестировал модели 5.2-5.5, ранние тесты брали другие. Четвёртый: подзапросы. ChatGPT ищет не по вашему ключу, а по переписанным запросам, и топ-10 по исходному ключу для него не определяющий. Это наша интерпретация, прямого эксперимента, который бы разделил эти факторы, мы не видели.
8% цитат ChatGPT приходилось на страницы из топ-10 Google. — Ahrefs, ~15 000 промптов, данные июля 2025
Практический вывод не зависит от того, какая цифра ближе к реальности. Позиции в Google остаются полезными, но, судя по данным, не как прямой сигнал: сайт, который индексируется и ранжируется, вероятно, чаще попадает в пул (это наша интерпретация). Достаточным условием они не являются, и проверять нужно именно цитирование.
Каким должен быть контент, чтобы его процитировали?
Чаще цитируют контент, который отвечает на конкретный подвопрос в начале страницы, имеет заголовок, близкий к формулировке запроса, и содержит проверяемые данные с указанием источника. Причинность этих признаков не доказана: они выведены из корреляций, а не из контролируемых экспериментов, поэтому воспринимайте их как рабочую гипотезу.
Если перевести то, как ChatGPT выбирает источники, в действия на странице, получится порядок работы, который можно выполнить за час:
- Выпишите 3-5 вопросов, на которые страница должна отвечать, и сформулируйте их так, как их задаёт читатель. Для CRM это «какая CRM подходит магазину на 50 заказов в день», а не «обзор CRM-систем».
- Сделайте заголовок страницы или раздела близким по смыслу к главному вопросу. Это связывает страницу с подзапросами, на которые разойдётся вопрос.
- Поставьте прямой ответ в первые абзацы. Вспомните цифру ziptie.dev: 44% цитат берутся из первой трети страницы (пересказ, методика не проверена).
- Добавьте конкретику: цифру, дату, название метода, источник. Утверждение вроде «многие компании так делают» не даёт модели ничего, что можно процитировать.
- Уберите из первой трети страницы вступление, историю компании и общие рассуждения. Они занимают место, где ожидается ответ.
Чего в этом списке нет: схем разметки, специальных тегов и llms.txt. Для разметки данных о влиянии на цитирование ChatGPT мы не нашли. По llms.txt исследования не показали связи с цитированием (подробнее в FAQ).
Какие технические условия нужны, чтобы сайт попал в поиск ChatGPT?
Нужно, чтобы OAI-SearchBot мог зайти на страницы: он не заблокирован в robots.txt, не режется файрволом или CDN, а его запросы с опубликованных IP-диапазонов проходят. Отдельного кабинета вебмастера, где можно подтвердить доступ или посмотреть показы, у OpenAI нет, поэтому проверять приходится по собственным логам.
Сайт, закрытый для OAI-SearchBot, не показывается в ответах поиска ChatGPT. Он всё ещё может появляться как навигационная ссылка, когда пользователь ищет конкретный сайт. Эта формулировка приведена по документации OpenAI в пересказе обзора eSEOspace.
На практике сбой чаще возникает не в robots.txt, а на уровне защиты. Если WAF или CDN, например с правилом «блокировать неизвестные боты», отдаёт OAI-SearchBot ошибку 403 или капчу, robots.txt разрешающий доступ ничего не меняет. Проверьте, что запросы с IP из searchbot.json проходят, и добавьте этот диапазон в список разрешённых.
По тому же обзору eSEOspace, на октябрь 2026 у OpenAI нет кабинета вебмастера, формы подачи URL и отчёта о показах в поиске ChatGPT, а полный список поисковых партнёров не раскрыт. Это значит, что подтверждение доступа можно получить только из своих серверных логов, а подтверждение цитирования только вручную.
Изменения в robots.txt могут применяться примерно за 24 часа. Эту цифру приводит searchengineworld.com в пересказе документации OpenAI, поэтому ждать мгновенного эффекта не стоит.
Помогают ли упоминания бренда на сторонних сайтах?
Прямого доказательства в данных нет. Это гипотеза: ChatGPT опирается на пул страниц из поиска, поэтому упоминания бренда на авторитетных сайтах, которые попадают в этот пул, могут повышать шанс цитирования. Проверки этой связи мы не нашли, а косвенные данные об источниках ChatGPT неоднозначны.
Что известно из исследований, говорит о том, что дело не в количестве упоминаний. По Ahrefs, Reddit даёт 67,8% нецитируемых URL и лишь 1,93% цитат: платформа с огромным числом упоминаний попадает в пул и почти не цитируется. Исследование arXiv 2601.17109 по медицинским запросам показывает другое: в ответах ChatGPT преобладают институциональные источники, коммерческие сайты дают меньше четверти цитат. Но это одна тематика, и для вопросов про CRM или SEO картина может быть иной.
Два факта в совокупности дают осторожный вывод. Тип площадки важнее объёма упоминаний, а для чувствительных тем модель, судя по данным, выбирает институциональные источники. Это наша интерпретация. Если вы работаете в такой нише, подумайте о публикациях на отраслевых или экспертных ресурсах, а не о массовых размещениях на площадках общего назначения.
Как проверить, цитирует ли ChatGPT ваш сайт?
Единого отчёта нет, поэтому проверка складывается из трёх источников: ручной прогон 15-20 вопросов в разных сессиях, аналитика переходов в GA4 и серверные логи. Каждый способ показывает свою часть картины: ручная проверка видит цитаты, GA4 видит клики, логи видят заходы бота, и ни один не даёт полной.
Ручная проверка. Составьте 15-20 вопросов, на которые должен отвечать ваш сайт, и задайте их в разных сессиях с включённым поиском. Выдача шумная (об этом пишут авторы препринта NUS), поэтому один прогон ничего не доказывает. Записывайте, на какие страницы ссылается ChatGPT, и повторяйте через неделю.
GA4. ChatGPT Search добавляет utm_source=chatgpt.com к исходящим ссылкам-источникам. В GA4 нет стандартного канала для ИИ-трафика, поэтому нужен собственный канал с правилом выше Referral. Пример условия для Source:
Источник (Source) соответствует регулярному выражению:
chatgpt\.com
Визиты из приложений и копипаст ссылки часто попадают в Direct, поэтому GA4 даёт нижнюю оценку реального трафика (по материалам wellows.com и clickport.io).
Серверные логи. Отфильтруйте запросы по user-agent и сверьте IP с опубликованными диапазонами:
grep -E "OAI-SearchBot|ChatGPT-User|GPTBot" /var/log/nginx/access.logСовпадение user-agent без совпадения IP может означать подделку (или устаревший список диапазонов, поэтому сначала обновите JSON), и такие запросы не стоит считать визитами бота OpenAI. Логи подтверждают только то, что бот заходил, но не то, что страница была процитирована.
Какие ошибки мешают попасть в ответы ChatGPT?
Основные ошибки лежат в трёх зонах: доступ ботов, структура страницы и ожидания от результата. Проверка занимает меньше часа и позволяет выявить сбои, о которых владелец сайта мог не знать: от блокировки поискового бота в robots.txt до ответа, спрятанного в конце длинной страницы.
- Блокировка OAI-SearchBot. Её ставят вместе с GPTBot, считая их одним ботом. По документации они независимы, и закрытый OAI-SearchBot убирает сайт из ответов поиска.
- Защита, которая режет бота. WAF или CDN отдаёт 403 или капчу, хотя robots.txt разрешает доступ.
- Ответ в конце страницы. Первая треть текста занята вступлением. По ziptie.dev (пересказ), 44% цитат берутся именно из начала страницы.
- Заголовок не совпадает с вопросом. Страница называется «Наши услуги» вместо «Сколько стоит доставка по Украине». Близость заголовка к запросу у цитируемых URL по Ahrefs выше.
- Оптимизация под один ключ. ChatGPT ищет по подзапросам, и страница, не закрывающая ни один узкий подзапрос, остаётся в пуле без цитаты.
- Ставка на llms.txt. Подтверждений, что OpenAI читает этот файл, нет, а время уходит на то, что на цитирование, по доступным исследованиям, не влияет.
FAQ
Можно ли заплатить за место в ответах ChatGPT?
В материалах OpenAI, которые мы использовали, платного способа попасть в источники поиска нет. Справка описывает ранжирование по нескольким факторам и прямо говорит, что место не гарантировано. Кабинета вебмастера, формы подачи URL и отчёта о показах у поиска ChatGPT тоже нет, так что договориться о цитировании некуда.
Повлияет ли блокировка GPTBot на видимость в ChatGPT?
По документации OpenAI, нет. GPTBot собирает данные для обучения моделей, а за показ сайтов в поиске отвечает OAI-SearchBot. Настройки ботов независимы, поэтому можно закрыть GPTBot и оставить OAI-SearchBot открытым. Важно не блокировать оба бота одним правилом по ошибке.
Сколько источников ChatGPT показывает в ответе?
Меньше, чем конкуренты. По arXiv 2604.25707 (602 промпта), в среднем ChatGPT даёт 6,88 цитаты на промпт, Google 12,06, Perplexity 16,35. Эти цифры зависят от выборки промптов и от того, как авторы считали цитаты, поэтому их нельзя сопоставлять с данными Ahrefs (около 16,57 цитируемых URL на промпт): там другая выборка, другая версия модели и другой способ подсчёта. Это наша интерпретация: при меньшем числе цитат конкуренция за каждое место в ответе ChatGPT выше, чем в Perplexity.
Нужен ли llms.txt, чтобы ChatGPT цитировал сайт?
Нет подтверждений, что OpenAI читает этот файл. Исследование SE Ranking по 300 тысячам доменов, анализ Ahrefs (97% файлов llms.txt без единого запроса) и данные Search Engine Land (6 цитат из 18 000) не нашли связи файла с цитированием. Создать его можно, но ждать эффекта не стоит.
Как быстро ChatGPT реагирует на изменения в robots.txt?
Изменения могут применяться примерно за 24 часа. Это цифра из пересказа документации OpenAI на searchengineworld.com, а не гарантия. После правки подождите сутки, проверьте по серверным логам, что OAI-SearchBot получает доступ, и только затем оценивайте результат.
С чего начать на этой неделе
Откройте robots.txt и проверьте, что OAI-SearchBot не заблокирован ни прямо, ни общим правилом. Затем найдите в серверных логах его запросы и убедитесь, что IP совпадают с openai.com/searchbot.json. Потом составьте 15 вопросов своей ниши и прогоните их в разных сессиях ChatGPT с поиском: так вы увидите, как ChatGPT выбирает источники именно в вашей теме и кого цитирует сейчас. Одну страницу, которая должна отвечать на такой вопрос, перепишите: заголовок под подвопрос, ответ в первых абзацах, данные с источником. Если нужен системный подход вместо разовых правок, посмотрите нашу работу по направлению продвижение в ChatGPT.
Источники
- OpenAI Help Center: ChatGPT Search
- OpenAI: документация по краулерам (GPTBot, OAI-SearchBot, ChatGPT-User)
- OpenAI: IP-диапазоны OAI-SearchBot
- OpenAI: IP-диапазоны GPTBot
- OpenAI: IP-диапазоны ChatGPT-User
- arXiv 2604.25707: сравнение числа цитат у ChatGPT, Google и Perplexity
- arXiv 2601.17109: источники ChatGPT в медицинских запросах
Об авторе
Команда LuchanLabs
SEO и GEO-стратеги
Выводим сайты в топ Google и делаем бренды заметными в ответах ChatGPT, Gemini и Perplexity. Пишем о том, что сами каждый день проверяем на проектах клиентов.
Все статьи блогаПохожие статьи
 AI Overview / GEO
Что такое llms.txt и зачем он сайту
Файл llms.txt обещает подсказать ИИ, какие страницы важны. Разбираем формат, данные Ahrefs и SE Ranking, позицию Google и по шагам показываем, как его создать.
 Команда LuchanLabs9 мин чтения
 Контент-маркетинг
Топ-5 ИИ-инструментов для контента в 2026 году
Рынок ИИ-ассистентов для текста растёт до $4,88 млрд, и вопрос уже не «стоит ли», а «какой именно». Разбираем пять проверенных инструментов: реальные цены, сильные стороны и ограничения, о которых не пишут на лендингах.
Команда LuchanLabs10 мин чтения