
Як ChatGPT вибирає джерела і як потрапити у відповіді
Розбір того, як ChatGPT шукає й цитує сайти: боти OpenAI, критерії відбору, розбіжності в даних досліджень і конкретні кроки для сайту.
 Команда LuchanLabsSEO та AIO-стратеги14 хв читання
Зміст статті
- Чи завжди ChatGPT бере відповіді з інтернету?
- Як ChatGPT вибирає джерела, коли шукає в мережі?
- Які боти OpenAI заходять на сайт і чим вони відрізняються?
- За якими критеріями ChatGPT обирає, яке джерело процитувати?
- Чи достатньо топ-10 Google, щоб потрапити у відповіді ChatGPT?
- Яким має бути контент, щоб його процитували?
- Які технічні умови потрібні, щоб сайт потрапив у пошук ChatGPT?
- Чи допомагають згадки бренду на сторонніх сайтах?
- Як перевірити, чи цитує ChatGPT ваш сайт?
- Які помилки заважають потрапити у відповіді ChatGPT?
- FAQ
- З чого почати цього тижня
Як ChatGPT вибирає джерела, OpenAI докладно не розкриває, але картина складається з офіційної документації та незалежних досліджень. Модель не завжди звертається до інтернету, а коли звертається, переписує запитання на кілька пошукових запитів і цитує лише близько половини знайдених сторінок. Нижче розібрано, що відомо достовірно, що показали дослідження, що лишається гіпотезою і які кроки сайт може зробити вже зараз.
Чи завжди ChatGPT бере відповіді з інтернету?
Ні. ChatGPT запускає вебпошук автоматично, коли вважає, що запитання виграє від даних з мережі, або коли користувач вмикає пошук вручну. В інших випадках модель відповідає без звернення до сайтів, і джерел у відповіді не буде. Це перша умова будь-якої видимості: немає пошуку, немає цитування.
Наскільки часто пошук запускається, залежить від типу запитань. У тесті iSonic від 9 вересня 2026 року 432 запитання для творців контенту надіслали через API ChatGPT із увімкненим вебпошуком. Пошук спрацював для 153 запитань (близько 35%), а в середньому на відповідь припало 0,9 джерела.
У цієї цифри два застереження. Тест ішов через API, а не через застосунок ChatGPT, і поведінка застосунку може відрізнятися. Запитання були однієї тематики, тому переносити 35% на будь-які запити не можна. Практичний висновок скромніший: для частини ваших тем ChatGPT узагалі не шукатиме в мережі, і боротися за цитату там марно. Починати варто із запитань, де пошук запускається майже напевно: порівняння, актуальні ціни, «що краще», нещодавні зміни.
Як ChatGPT вибирає джерела, коли шукає в мережі?
ChatGPT переписує запитання користувача на один або кілька цільових пошукових запитів і надсилає їх у пошук, іноді через партнерських пошукових провайдерів. Зі знайденого пулу сторінок він потім обирає, що процитувати. Панель Sources показує цитовані джерела й інші релевантні посилання, а місце в ній не гарантоване.
Довідка OpenAI наводить приклад такого ланцюжка. Запит про препарати проти CCR8 спочатку перетворюється на запит про розробку імунотерапії, а потім на вужчий запит про конкретну молекулу й наукову конференцію. Повного списку партнерів OpenAI не розкриває, тому сказати, які саме індекси стоять за пошуком, не можна.
Для звичайного бізнес-запитання схема виглядає так. Нижче ілюстрація, а не реальний лог ChatGPT: запитання «Яку CRM обрати для невеликого інтернет-магазину?» може розійтися на підзапити «CRM для інтернет-магазину порівняння», «CRM інтеграція з Новою поштою» і «ціни на CRM для малого бізнесу». Кожен підзапит приносить свій набір сторінок. Сторінка, яка точно відповідає на один вузький підзапит, має більше шансів, ніж універсальна, що відповідає на вихідне запитання в загальних рисах.
Дослідження Ahrefs від 15 квітня 2026 року (1,4 млн промптів) показує масштаб відбору. ChatGPT у середньому дістає близько 16,57 цитованих і близько 16,58 нецитованих URL на промпт, тобто цитується приблизно половина знайденого. Із цитованих URL 88% надходять із каналу general search. Ahrefs застерігає, що ChatGPT є закритою моделлю, а оцінки приблизні. Цю цифру не можна напряму порівнювати з 6,88 цитати на промпт з іншого дослідження (див. FAQ): вибірки, моделі та способи підрахунку в них різні.
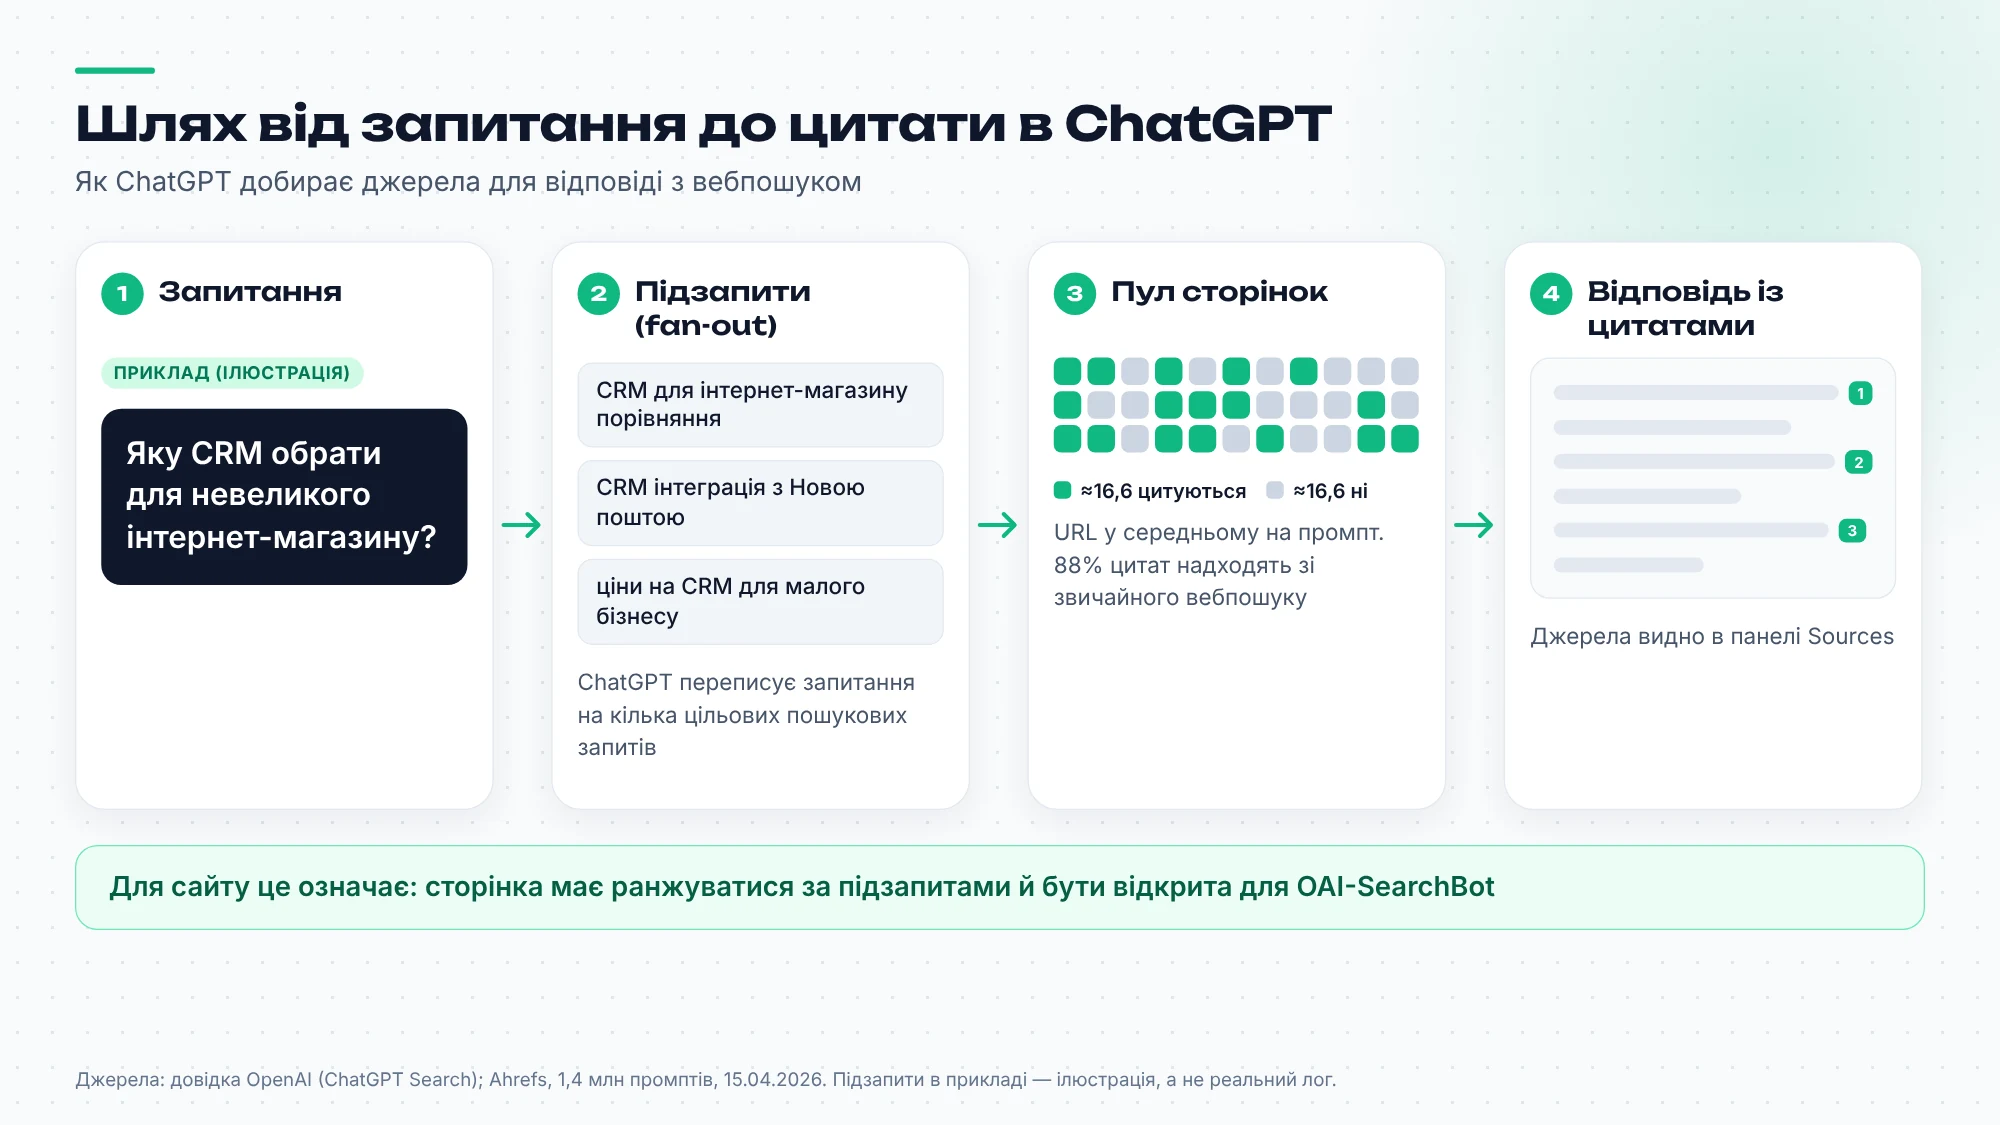
~50% знайдених URL ChatGPT цитує, решта ~50% лишаються в пулі без цитати. — Ahrefs, 15 квітня 2026, 1,4 млн промптів
Які боти OpenAI заходять на сайт і чим вони відрізняються?
У OpenAI три боти з різними завданнями: GPTBot збирає дані для навчання моделей, OAI-SearchBot формує показ сайтів у пошуку ChatGPT, ChatGPT-User виконує дії, запущені користувачем. Налаштування ботів незалежні: закривши один, ви не закриваєте решту, тому для видимості у відповідях критичний саме OAI-SearchBot.
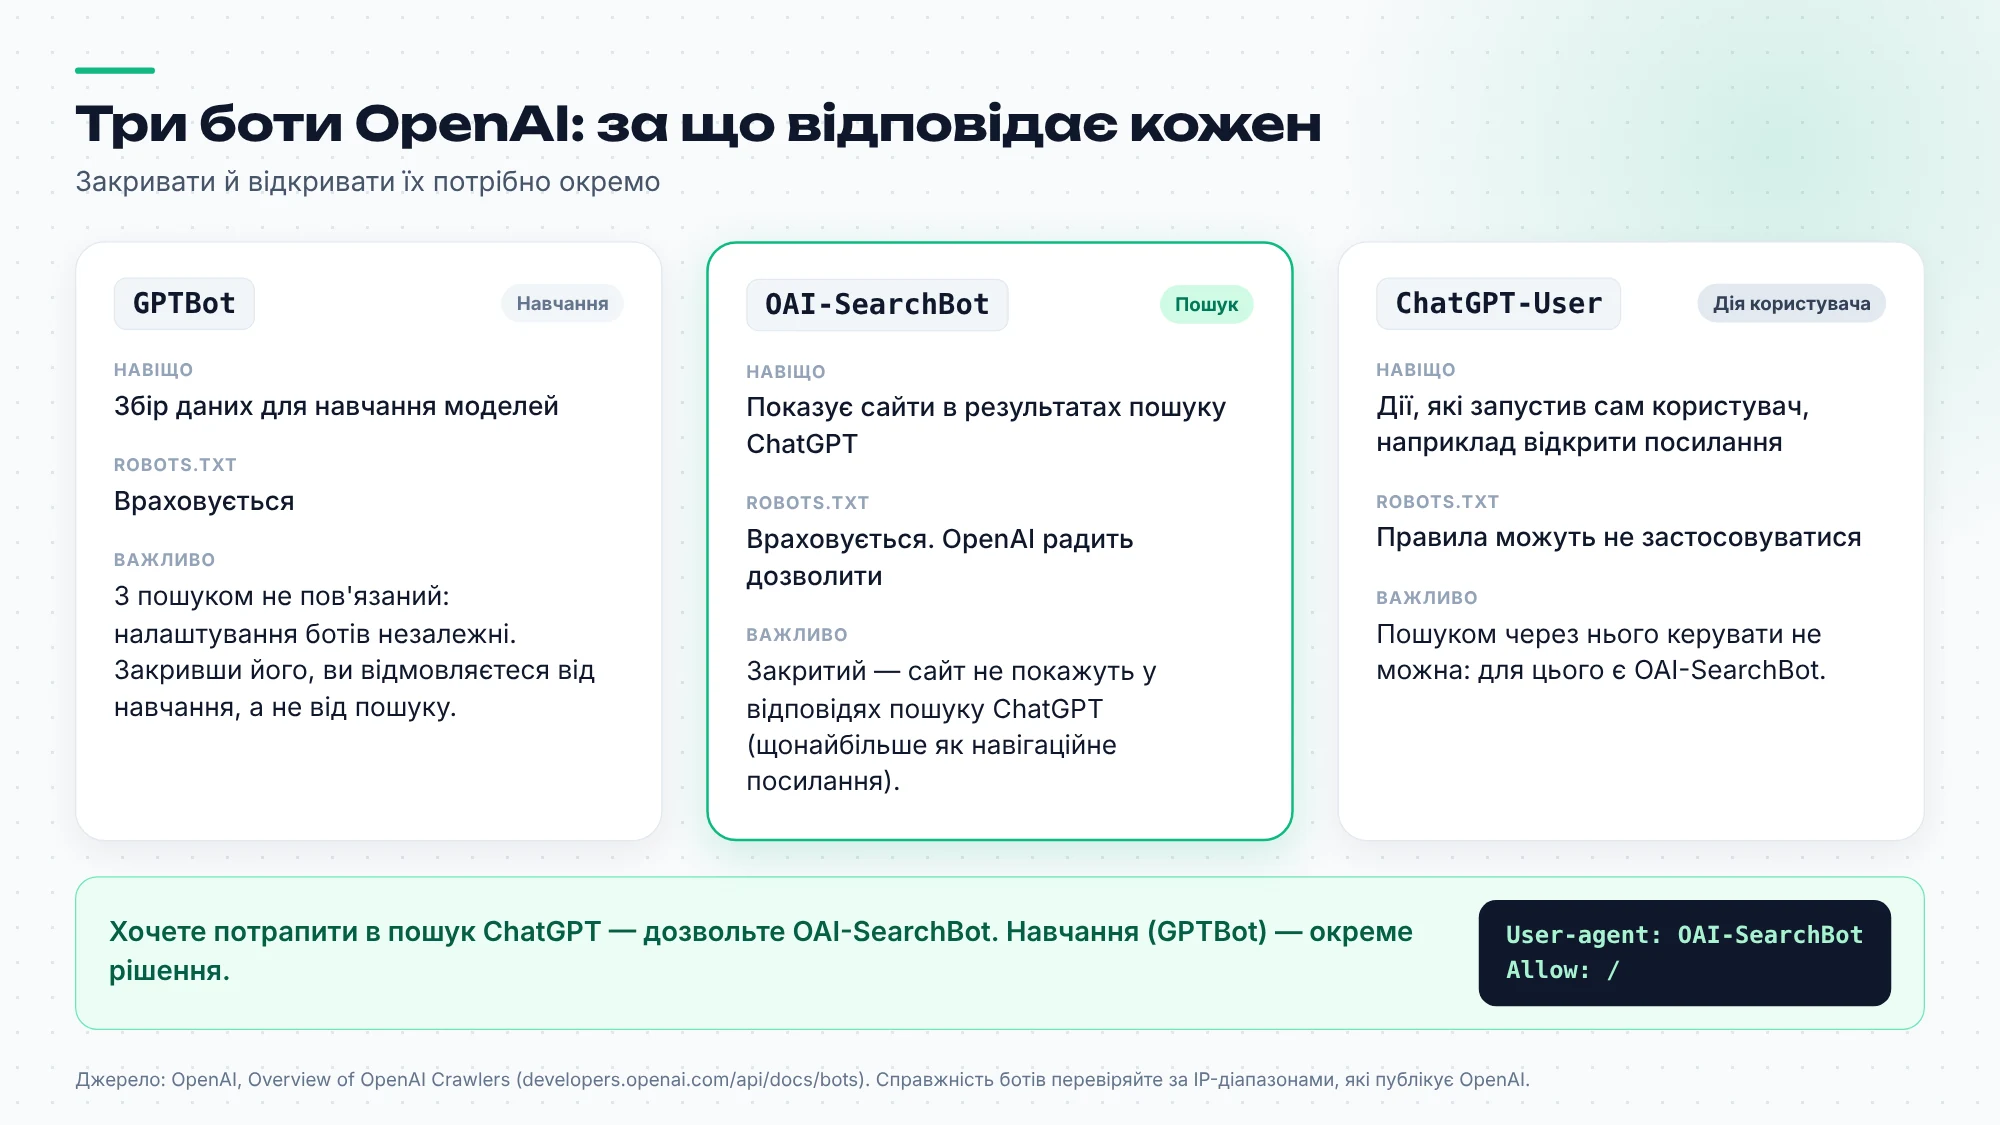
| Бот | Призначення | Чи враховує robots.txt | Чи впливає на появу в пошуку ChatGPT |
|---|---|---|---|
| GPTBot | Навчання моделей | Так | Ні, він відповідає за навчання, а не за пошук |
| OAI-SearchBot | Показ сайтів у пошуку ChatGPT | Так; OpenAI радить його дозволити | Так, це бот пошукового шару |
| ChatGPT-User | Дії, запущені користувачем | Правила robots.txt до нього можуть не застосовуватися | У документації описаний як інструмент дій користувача, а не індексації |
OpenAI рекомендує однозначно: дозволити OAI-SearchBot у robots.txt і пропускати запити з опублікованих діапазонів IP. Діапазони лежать у JSON-файлах: openai.com/searchbot.json, openai.com/gptbot.json і openai.com/chatgpt-user.json.
Типовий вибір власника сайту: бути в пошуку ChatGPT, але не віддавати контент на навчання. Він реалізується так:
# Дозволяємо бот пошуку ChatGPT
User-agent: OAI-SearchBot
Allow: /

# Забороняємо збір даних для навчання моделей (за бажанням)
User-agent: GPTBot
Disallow: /

# Дії, запущені користувачем
# OpenAI попереджає, що до ChatGPT-User правила robots.txt можуть не застосовуватися
User-agent: ChatGPT-User
Allow: /
Блок GPTBot із Disallow: / — це рішення бізнесу, а не технічна вимога. Якщо ви не проти навчання на ваших матеріалах, його можна не додавати. Блокування GPTBot, за документацією, на показ у пошуку не впливає.
За якими критеріями ChatGPT обирає, яке джерело процитувати?
Офіційно OpenAI каже лише, що ранжування йде за кількома чинниками, а місце у відповіді не гарантується. Дослідження дають непрямі ознаки: цитовані сторінки ближчі за змістом заголовка до запиту й підзапитів, частіше повторюються у видачі за різними підзапитами й нерідко відповідають на початку сторінки.
Ahrefs виміряв близькість заголовка до запиту як косинусну близькість ембедингів. До вихідного промпту вона становила 0,602 у цитованих сторінок і 0,484 у нецитованих. До внутрішніх підзапитів (fan-out) у цитованих сторінок вона дорівнює 0,656. Це найчіткіший сигнал із доступних: заголовок, який збігається за змістом із запитанням і його підзапитаннями, корелює з цитуванням.
Препринт Національного університету Сінгапуру «Understanding ChatGPT Citations…» (2026, не рецензований; 80 запитів китайською й англійською, моделі ChatGPT 5.2-5.5) додає другу ознаку. Сторінки, які повторюються у видачі за різними підзапитами, цитуються частіше. Автори також зазначають, що видача шумна: те саме запитання може дати різні пули сторінок.
Третя ознака прийшла з вторинного джерела. За переказом аналізу 1,2 млн відповідей на ziptie.dev, 44% цитат беруться з першої третини сторінки. Саму методику ми не перевіряли, тому ставтеся до цифри як до орієнтира.
Ще одна деталь з Ahrefs: ChatGPT масово дістає YouTube і arXiv, але цитує їх рідко. Reddit дає 67,8% нецитованих URL і лише 1,93% цитат. Потрапляння сторінки в пул не означає цитати.
Важливе застереження самого Ahrefs: надійних висновків про роль сніпетів і дат публікації зробити не можна. Усі перелічені ознаки є кореляціями, причинність не доведена.
Чи достатньо топ-10 Google, щоб потрапити у відповіді ChatGPT?
Ні, і дані досліджень розходяться. За Ahrefs, лише близько 8% цитат ChatGPT припадає на сторінки з топ-10 Google, тоді як за раннім тестом Seer Interactive 87% цитат збіглися з топ-10 Bing. Єдиної цифри немає: у досліджень різні метод і період, тому усереднювати ці значення не можна.
Ось усі дані, які ми знайшли, з методом кожного:
- Ahrefs, близько 15 000 промптів, дані липня 2025: 8% цитат ChatGPT у топ-10 Google і близько 8,1% у топ-10 Bing.
- Seer Interactive, 500+ цитат, початок 2025: 87% збіглися з топ-10 Bing. Вибірка мала й рання, метод відомий нам у переказі.
- GeekyTech, 2026: перетин доменів 0,104 з Google і 0,035 з Bing. Тут інша метрика: домени, а не URL.
- Препринт NUS: Google Search і OpenAI Responses API разом відтворюють близько чверті цитованих URL, але близько половини цитованих хостів.
Розбіжність пояснюють чотири чинники. Перший: метрика. Збіг за точним URL завжди нижчий, ніж за доменом чи хостом: ChatGPT може процитувати іншу сторінку того самого сайту, який є в топі. Другий: час. Дані збирали в різні періоди, а пошуковий шар ChatGPT змінювався. Третій: версії моделі. Препринт NUS тестував моделі 5.2-5.5, ранні тести брали інші. Четвертий: підзапити. ChatGPT шукає не за вашим ключем, а за переписаними запитами, і топ-10 за вихідним ключем для нього не визначальний. Це наша інтерпретація, прямого експерименту, який розділив би ці чинники, ми не бачили.
8% цитат ChatGPT припадало на сторінки з топ-10 Google. — Ahrefs, ~15 000 промптів, дані липня 2025
Практичний висновок не залежить від того, яка цифра ближча до реальності. Позиції в Google лишаються корисними, але, судячи з даних, не як прямий сигнал: сайт, який індексується й ранжується, ймовірно, частіше потрапляє в пул (це наша інтерпретація). Достатньою умовою вони не є, і перевіряти треба саме цитування.
Яким має бути контент, щоб його процитували?
Частіше цитують контент, який відповідає на конкретне підзапитання на початку сторінки, має заголовок, близький до формулювання запиту, і містить перевірювані дані із зазначенням джерела. Причинність цих ознак не доведена: їх виведено з кореляцій, а не з контрольованих експериментів, тому сприймайте їх як робочу гіпотезу.
Якщо перекласти те, як ChatGPT вибирає джерела, на дії на сторінці, вийде порядок роботи, який можна виконати за годину:
- Випишіть 3-5 запитань, на які сторінка має відповідати, і сформулюйте їх так, як їх ставить читач. Для CRM це «яка CRM підійде магазину на 50 замовлень на день», а не «огляд CRM-систем».
- Зробіть заголовок сторінки чи розділу близьким за змістом до головного запитання. Це пов'язує сторінку з підзапитами, на які розійдеться запитання.
- Поставте пряму відповідь у перші абзаци. Згадайте цифру ziptie.dev: 44% цитат беруться з першої третини сторінки (переказ, методику не перевірено).
- Додайте конкретику: цифру, дату, назву методу, джерело. Твердження на кшталт «багато компаній так роблять» не дає моделі нічого, що можна процитувати.
- Приберіть із першої третини сторінки вступ, історію компанії й загальні міркування. Вони займають місце, де очікують відповідь.
Чого в цьому списку немає: схем розмітки, спеціальних тегів і llms.txt. Для розмітки даних про вплив на цитування ChatGPT ми не знайшли. Щодо llms.txt дослідження не показали зв'язку з цитуванням (докладніше у FAQ).
Які технічні умови потрібні, щоб сайт потрапив у пошук ChatGPT?
Потрібно, щоб OAI-SearchBot міг зайти на сторінки: він не заблокований у robots.txt, не відсікається файрволом чи CDN, а його запити з опублікованих діапазонів IP проходять. Окремого кабінету вебмайстра, де можна підтвердити доступ або подивитися покази, в OpenAI немає, тому перевіряти доводиться за власними логами.
Сайт, закритий для OAI-SearchBot, не показується у відповідях пошуку ChatGPT. Він усе ще може з'являтися як навігаційне посилання, коли користувач шукає конкретний сайт. Це формулювання наведено за документацією OpenAI у переказі огляду eSEOspace.
На практиці збій частіше виникає не в robots.txt, а на рівні захисту. Якщо WAF чи CDN, наприклад із правилом «блокувати невідомих ботів», віддає OAI-SearchBot помилку 403 або капчу, robots.txt, що дозволяє доступ, нічого не змінює. Перевірте, що запити з IP із searchbot.json проходять, і додайте цей діапазон до списку дозволених.
За тим самим оглядом eSEOspace, станом на жовтень 2026 року в OpenAI немає кабінету вебмайстра, форми подання URL і звіту про покази в пошуку ChatGPT, а повний список пошукових партнерів не розкрито. Це означає, що підтвердження доступу можна отримати лише з власних серверних логів, а підтвердження цитування лише вручну.
Зміни в robots.txt можуть застосовуватися приблизно за 24 години. Цю цифру наводить searchengineworld.com у переказі документації OpenAI, тому чекати миттєвого ефекту не варто.
Чи допомагають згадки бренду на сторонніх сайтах?
Прямого доказу в даних немає. Це гіпотеза: ChatGPT спирається на пул сторінок із пошуку, тому згадки бренду на авторитетних сайтах, які потрапляють у цей пул, можуть підвищувати шанс цитування. Перевірки цього зв'язку ми не знайшли, а непрямі дані про джерела ChatGPT неоднозначні.
Те, що відомо з досліджень, свідчить, що справа не в кількості згадок. За Ahrefs, Reddit дає 67,8% нецитованих URL і лише 1,93% цитат: платформа з величезною кількістю згадок потрапляє в пул і майже не цитується. Дослідження arXiv 2601.17109 за медичними запитами показує інше: у відповідях ChatGPT переважають інституційні джерела, а комерційні сайти дають менше чверті цитат. Але це одна тематика, і для запитань про CRM чи SEO картина може бути іншою.
Два факти разом дають обережний висновок. Тип майданчика важливіший за обсяг згадок, а для чутливих тем модель, судячи з даних, обирає інституційні джерела. Це наша інтерпретація. Якщо ви працюєте в такій ніші, подумайте про публікації на галузевих чи експертних ресурсах, а не про масові розміщення на майданчиках загального призначення.
Як перевірити, чи цитує ChatGPT ваш сайт?
Єдиного звіту немає, тому перевірка складається з трьох джерел: ручний прогін 15-20 запитань у різних сесіях, аналітика переходів у GA4 і серверні логи. Кожен спосіб показує свою частину картини: ручна перевірка бачить цитати, GA4 бачить кліки, логи бачать заходи бота, і жоден не дає повної.
Ручна перевірка. Складіть 15-20 запитань, на які має відповідати ваш сайт, і поставте їх у різних сесіях із увімкненим пошуком. Видача шумна (про це пишуть автори препринта NUS), тому один прогін нічого не доводить. Записуйте, на які сторінки посилається ChatGPT, і повторюйте через тиждень.
GA4. ChatGPT Search додає utm_source=chatgpt.com до вихідних посилань-джерел. У GA4 немає стандартного каналу для ШІ-трафіку, тому потрібен власний канал із правилом вище за Referral. Приклад умови для Source:
Джерело (Source) відповідає регулярному виразу:
chatgpt\.com
Візити із застосунків і копіювання посилання часто потрапляють у Direct, тому GA4 дає нижню оцінку реального трафіку (за матеріалами wellows.com і clickport.io).
Серверні логи. Відфільтруйте запити за user-agent і звірте IP з опублікованими діапазонами:
grep -E "OAI-SearchBot|ChatGPT-User|GPTBot" /var/log/nginx/access.logЗбіг user-agent без збігу IP може означати підробку (або застарілий список діапазонів, тому спершу оновіть JSON), і такі запити не варто вважати візитами бота OpenAI. Логи підтверджують лише те, що бот заходив, але не те, що сторінку процитовано.
Які помилки заважають потрапити у відповіді ChatGPT?
Основні помилки лежать у трьох зонах: доступ ботів, структура сторінки й очікування від результату. Перевірка займає менш як годину й дає змогу виявити збої, про які власник сайту міг не знати: від блокування пошукового бота в robots.txt до відповіді, захованої наприкінці довгої сторінки.
- Блокування OAI-SearchBot. Його ставлять разом із GPTBot, вважаючи їх одним ботом. За документацією вони незалежні, і закритий OAI-SearchBot прибирає сайт із відповідей пошуку.
- Захист, що відсікає бота. WAF або CDN віддає 403 чи капчу, хоча robots.txt дозволяє доступ.
- Відповідь наприкінці сторінки. Перша третина тексту зайнята вступом. За ziptie.dev (переказ), 44% цитат беруться саме з початку сторінки.
- Заголовок не збігається із запитанням. Сторінка називається «Наші послуги» замість «Скільки коштує доставка по Україні». Близькість заголовка до запиту в цитованих URL за Ahrefs вища.
- Оптимізація під один ключ. ChatGPT шукає за підзапитами, і сторінка, що не закриває жодного вузького підзапиту, лишається в пулі без цитати.
- Ставка на llms.txt. Підтверджень, що OpenAI читає цей файл, немає, а час іде на те, що на цитування, за доступними дослідженнями, не впливає.
FAQ
Чи можна заплатити за місце у відповідях ChatGPT?
У матеріалах OpenAI, які ми використали, платного способу потрапити в джерела пошуку немає. Довідка описує ранжування за кількома чинниками й прямо каже, що місце не гарантоване. Кабінету вебмайстра, форми подання URL і звіту про покази в пошуку ChatGPT теж немає, тож домовитися про цитування ніде.
Чи вплине блокування GPTBot на видимість у ChatGPT?
За документацією OpenAI, ні. GPTBot збирає дані для навчання моделей, а за показ сайтів у пошуку відповідає OAI-SearchBot. Налаштування ботів незалежні, тому можна закрити GPTBot і залишити OAI-SearchBot відкритим. Важливо не заблокувати обидва боти одним правилом помилково.
Скільки джерел ChatGPT показує у відповіді?
Менше, ніж конкуренти. За arXiv 2604.25707 (602 промпти), у середньому ChatGPT дає 6,88 цитати на промпт, Google 12,06, Perplexity 16,35. Ці цифри залежать від вибірки промптів і від того, як автори рахували цитати, тому їх не можна зіставляти з даними Ahrefs (близько 16,57 цитованих URL на промпт): там інша вибірка, інша версія моделі й інший спосіб підрахунку. Це наша інтерпретація: за меншої кількості цитат конкуренція за кожне місце у відповіді ChatGPT вища, ніж у Perplexity.
Чи потрібен llms.txt, щоб ChatGPT цитував сайт?
Підтверджень, що OpenAI читає цей файл, немає. Дослідження SE Ranking за 300 тисячами доменів, аналіз Ahrefs (97% файлів llms.txt без жодного запиту) і дані Search Engine Land (6 цитат із 18 000) не знайшли зв'язку файлу з цитуванням. Створити його можна, але чекати ефекту не варто.
Як швидко ChatGPT реагує на зміни в robots.txt?
Зміни можуть застосовуватися приблизно за 24 години. Це цифра з переказу документації OpenAI на searchengineworld.com, а не гарантія. Після правки зачекайте добу, перевірте за серверними логами, що OAI-SearchBot отримує доступ, і лише тоді оцінюйте результат.
З чого почати цього тижня
Відкрийте robots.txt і перевірте, що OAI-SearchBot не заблоковано ні прямо, ні загальним правилом. Потім знайдіть у серверних логах його запити й переконайтеся, що IP збігаються з openai.com/searchbot.json. Далі складіть 15 запитань своєї ніші й поставте їх у різних сесіях ChatGPT із пошуком: так ви побачите, як ChatGPT вибирає джерела саме у вашій темі та кого цитує зараз. Одну сторінку, яка має відповідати на таке запитання, перепишіть: заголовок під підзапитання, відповідь у перших абзацах, дані з джерелом. Якщо потрібен системний підхід замість разових правок, подивіться нашу роботу за напрямом просування в ChatGPT.
Джерела
- OpenAI Help Center: ChatGPT Search
- OpenAI: документація щодо краулерів (GPTBot, OAI-SearchBot, ChatGPT-User)
- OpenAI: діапазони IP OAI-SearchBot
- OpenAI: діапазони IP GPTBot
- OpenAI: діапазони IP ChatGPT-User
- arXiv 2604.25707: порівняння кількості цитат у ChatGPT, Google і Perplexity
- arXiv 2601.17109: джерела ChatGPT у медичних запитах
Про автора
Команда LuchanLabs
SEO та AIO-стратеги
Виводимо сайти в топ Google і робимо бренди видимими у відповідях ChatGPT, Gemini та Perplexity. Пишемо про те, що самі щодня перевіряємо на проєктах клієнтів.
Усі статті блогуСхожі статті
 AI Overview / GEO
llms.txt: що це, як створити і чи працює у 2026
Файл llms.txt обіцяє підказати ШІ, які сторінки важливі. Розбираємо формат, дані Ahrefs і SE Ranking, позицію Google та покроково показуємо, як його створити.
 Команда LuchanLabs9 хв читання
 Контент-маркетинг
Топ-5 ШІ-інструментів для написання контенту у 2026 році
Ринок ШІ-асистентів для тексту росте до $4,88 млрд, і питання вже не «чи варто», а «який саме». Розбираємо п'ять перевірених інструментів: реальні ціни, сильні сторони й обмеження, про які не пишуть на лендингах.
Команда LuchanLabs10 хв читання